Noindex
Was ist ein Noindex?
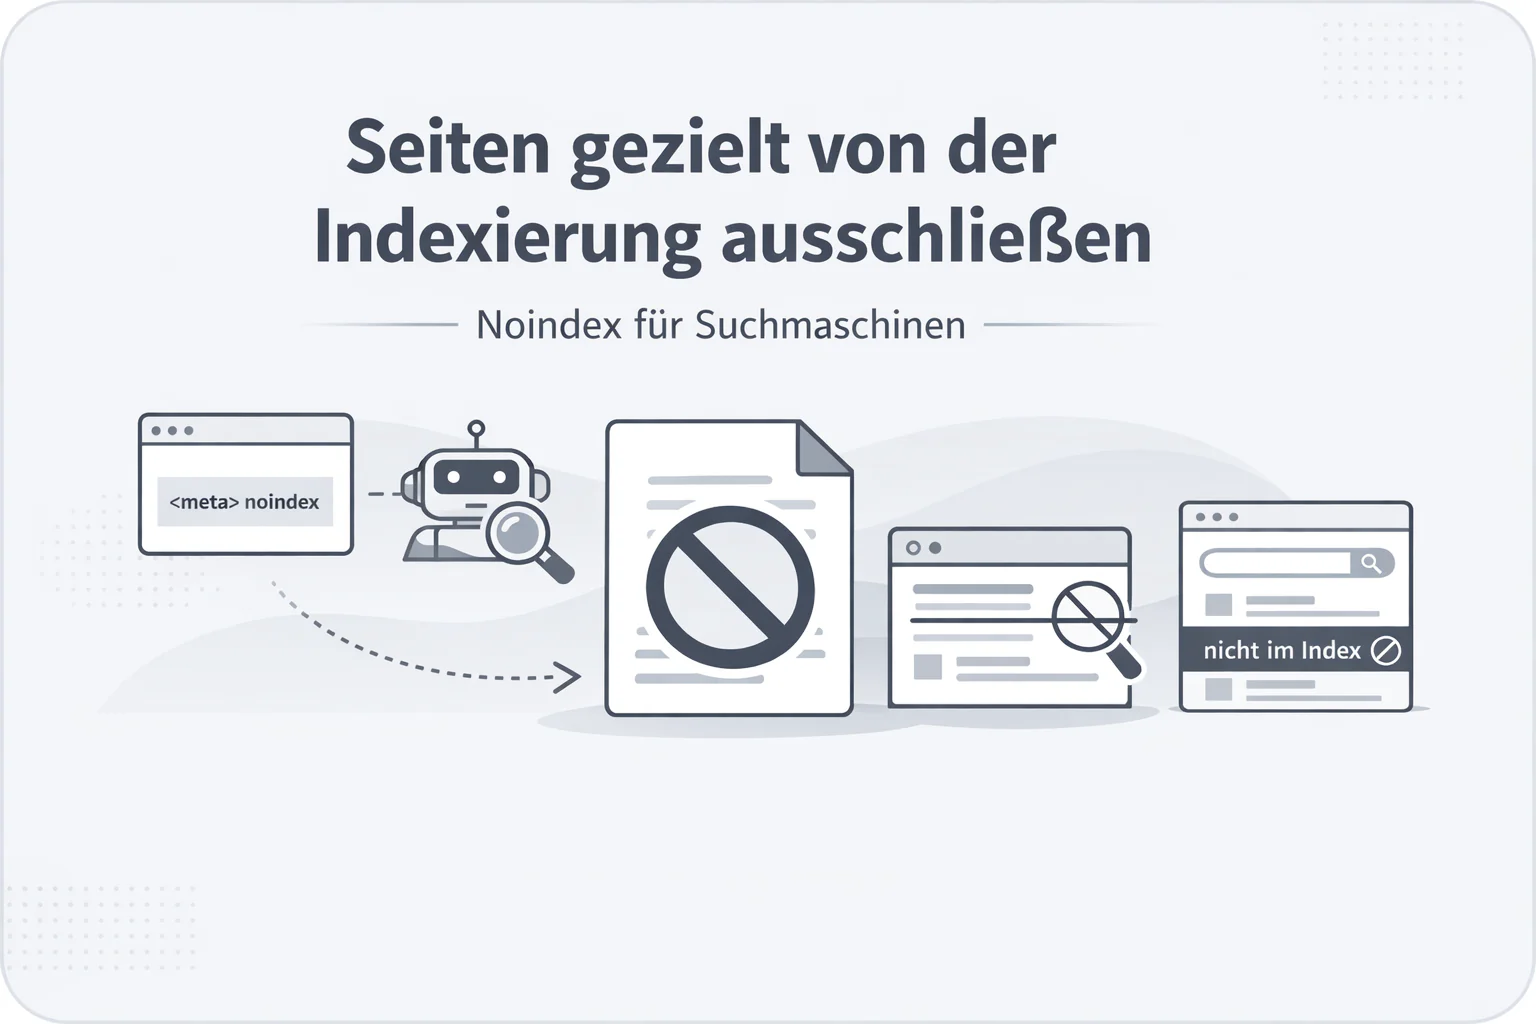
Ein Noindex ist eine Anweisung an Suchmaschinen, eine bestimmte URL nicht in den Index aufzunehmen. Die Seite kann weiterhin aufrufbar sein, soll aber nicht in Suchergebnissen erscheinen. Noindex wird vor allem über Meta-Tags oder HTTP-Header technisch umgesetzt.
1. Grundlagen: Definition von Noindex
Der Begriff Noindex bezeichnet eine spezielle Anweisung für Suchmaschinen-Crawler, dass eine konkrete Seite zwar gecrawlt, aber nicht in den Suchindex übernommen werden soll. Diese Seiten können weiterhin über direkte Links erreicht werden, erscheinen jedoch nicht in den organischen Suchergebnissen.
Technisch wird ein Noindex in der Regel über das Meta-Robots-Tag im HTML-Head oder über den HTTP-Header gesetzt. Beide Varianten verfolgen dasselbe Ziel: die Steuerung, welche Inhalte einer Website für die Suche relevant sind und welche bewusst ausgeblendet werden.
2. Wie funktioniert ein Noindex technisch?
Ein Noindex gibt Suchmaschinen-Crawlern (z. B. Googlebot) eine klare Richtlinie, wie mit einer Seite verfahren werden soll. Um zu wirken, muss der Crawler die Seite mindestens einmal aufrufen können. Erst dann kann er die Anweisung auslesen und berücksichtigen.
2.1 Noindex per Meta-Robots-Tag
Die verbreitetste Methode ist das Meta-Robots-Tag im <head>-Bereich einer HTML-Seite. Ein typisches Beispiel sieht so aus:
<meta name="robots" content="noindex,follow">Wichtige Varianten des Meta-Robots-Tags:
Die Kombination aus Noindex und Follow ist im E-Commerce häufig sinnvoll, weil so Linkjuice weitergegeben wird, ohne die Seite selbst sichtbar zu machen.
2.2 Noindex per HTTP-Header (x-robots-tag)
Alternativ kann ein Noindex über den HTTP-Header gesetzt werden. Das ist besonders nützlich für nicht-HTML-Dateien wie PDFs oder Bilddateien, aber auch für dynamisch generierte Inhalte.
X-Robots-Tag: noindex, followDiese Variante wird auf Webserver- oder Applikationsebene konfiguriert und eignet sich für ganze Pfade oder Dateitypen, etwa um alle PDF-Anleitungen eines Shops aus dem Index zu nehmen, während die Produktseiten indexiert bleiben.
2.3 Voraussetzungen, damit Noindex wirkt
3. Zweck und Einsatzgebiete von Noindex im E-Commerce
Ein sauber eingesetztes Noindex ist ein wichtiges Werkzeug der technischen Suchmaschinenoptimierung. Es hilft, den Index einer Website zu bereinigen, Crawl-Budget zu schonen und Probleme mit Duplicate Content zu reduzieren.
3.1 Typische Seitentypen für Noindex
Im E-Commerce geht es dabei vor allem darum, Produkt- und Kategorieseiten als zentrale Einstiegsseiten zu stärken, während technische Hilfsseiten oder nutzerindividuelle Ansichten aus den organischen Ergebnissen ferngehalten werden.
3.2 Noindex und Crawling-Optimierung
Durch den gezielten Einsatz von Noindex kannst du den Fokus der Suchmaschinen auf deine wirklich relevanten Seiten lenken. Je weniger unwichtige oder redundante URLs im Index landen, desto klarer ist die Struktur deiner Domain aus Sicht der Suchmaschine.
Dadurch profitierst du indirekt von einer Optimierung des Crawlings, weil Crawler häufiger jene Seiten besuchen, die wirklich Rankings und Umsatz bringen, statt Ressourcen auf wenig nützliche URLs zu verschwenden.
4. Abgrenzung: Noindex, Nofollow, Disallow und Canonical
Der Begriff Noindex wird häufig mit anderen Steuerungsbefehlen verwechselt. Eine saubere Trennung ist wichtig, um Fehlkonfigurationen zu vermeiden.
4.1 Noindex vs. Nofollow
Ein Noindex allein verhindert nicht, dass die Seite gecrawlt oder intern verlinkt wird. Durch die Kombination noindex,follow kannst du die Seite aus dem Index herausnehmen und gleichzeitig die interne Verlinkung beibehalten.
4.2 Noindex vs. Disallow in robots.txt
Die robots.txt-Datei erlaubt dir, bestimmte Pfade vom Crawling auszuschließen (Disallow). Sie steuert nicht direkt, ob eine Seite im Index erscheint. Wird eine URL disallowed, kann sie theoretisch trotzdem in den Index gelangen, wenn externe Links darauf verweisen.
Für die gezielte Entfernung von Seiten aus dem Index ist Noindex daher die zuverlässigere Lösung als ein reines Disallow.
4.3 Noindex vs. Canonical-Tag
Das Canonical-Tag weist auf die bevorzugte Version einer Seite hin, wenn mehrere sehr ähnliche Varianten existieren (z. B. Filter-URLs versus Standard-Kategorieseite). Es ist eine Empfehlung an die Suchmaschine, keine harte Sperre.
In komplexen E-Commerce-Strukturen werden Canonical-Tags und Noindex häufig kombiniert, um sowohl Signalkonsolidierung als auch Indexsteuerung sauber abzubilden.
5. Best Practices für Noindex im Online-Shop
Gerade bei großen Sortiments-Shops mit vielen SKUs ist ein regelbasierter Ansatz für Noindex entscheidend, um Struktur, SEO-Performance und Crawling effizient zu steuern.
5.1 Strategische Ziele definieren
Bevor du Noindex-Regeln implementierst, sollte klar sein, welche Seitentypen in Google sichtbar sein sollen und welche nicht. Hilfreiche Leitfragen sind:
5.2 Typische Noindex-Regeln nach Seitentyp
| Seitentyp | Empfehlung |
|---|---|
| Produktseite | In der Regel index, follow |
| Kategorieseite | Index, follow; Paginierung oft noindex, follow |
| Interne Suche | Noindex, follow |
| Filter-URLs ohne Mehrwert | Noindex, follow oder komplett vermeiden |
| Warenkorb, Checkout | Noindex, nofollow |
| Login, Konto | Noindex, nofollow |
| Staging/Test | Noindex plus Zugriffsschutz |
5.3 Automatisierung statt manueller Pflege
In mittelgroßen und großen Shops ist es kaum möglich, alle Noindex-Fälle manuell zu verwalten. Sinnvoll ist eine Automatisierung entlang klarer Regeln, zum Beispiel:
Tools, die direkt aus Produktfeeds und Attributen Content generieren, können diese Regeln pro Kategorie und Seitentyp berücksichtigen und damit systematisch umsetzen.
6. Noindex in Verbindung mit KI-generiertem Produktcontent
Wenn Produkttexte aus Feeds automatisiert erstellt werden, etwa mit spezialisierten KI-Lösungen, spielt Noindex eine wichtige Rolle bei Qualitätssicherung und Rollout-Strategie.
6.1 Sicherer Rollout neuer Inhalte
So kombinierst du die Geschwindigkeit automatisierter Content-Produktion mit einem kontrollierten SEO-Rollout, ohne unfertige Inhalte in den Index zu bringen.
6.2 Umgang mit Massenänderungen und Content-Refreshes
Bei großflächigen Aktualisierungen, etwa saisonalen Content-Refreshes oder Strukturänderungen, kann Noindex helfen, Übergangsphasen sauber zu steuern. Beispielsweise kannst du alte Kampagnen-URLs auf Noindex stellen, während neue Landingpages mit optimiertem Produktcontent live gehen.
7. Typische Fehler und Risiken beim Einsatz von Noindex
Falsch gesetzte Noindex-Tags gehören zu den häufigsten Ursachen für plötzliche Sichtbarkeitsverluste in Suchmaschinen. Eine saubere Kontrolle ist daher essenziell.
7.1 Kritische Fehlerquellen
7.2 Monitoring und Qualitätskontrolle
Um Risiken zu minimieren, solltest du regelmäßig prüfen, welche Seiten mit Noindex versehen sind und wie sich dies auf deine SEO-Kennzahlen auswirkt. Hilfreiche Maßnahmen sind:
7.3 Technische Überprüfung mit SEO-Checker
Für eine schnelle Einschätzung, ob kritische Seiten versehentlich auf Noindex stehen oder falsch verlinkt sind, kann ein OnPage-SEO-Check sinnvoll sein.


8. Best Practices zur Kombination von Noindex und interner Verlinkung
Auch wenn eine Seite auf Noindex steht, bleibt sie Teil der internen Verlinkungsstruktur, sofern du sie nicht aktiv aus Menüs und Modulen entfernst. Das kann sinnvoll sein, wenn du Linksignale steuern willst.
8.1 Noindex,follow als Standard für Hilfsseiten
Für viele Hilfs- und Funktionsseiten ist die Kombination noindex,follow sinnvoll:
So profitieren Produkt- und Kategorieseiten von eingehenden Links, auch wenn die verlinkenden Seiten nicht in den Suchergebnissen erscheinen sollen.
8.2 Wann noindex,nofollow sinnvoll ist
Die strengere Variante noindex,nofollow wird vor allem bei sensiblen oder rein technischen Seiten eingesetzt, zum Beispiel:
Hier sollen Suchmaschinen weder die Seite indexieren noch Links von dort aus bewerten, um vertrauliche Bereiche und unnötige Linksignale zu vermeiden.
9. Häufige Fragen zu Noindex
Wie setze ich ein Noindex Meta-Tag richtig ein?
Ein Noindex Meta-Tag wird im Head-Bereich einer HTML-Seite eingebunden, zum Beispiel mit dem Tag meta name='robots' content='noindex,follow'. Wichtig ist, dass der Crawler die Seite aufrufen kann und dass das Tag nicht durch widersprüchliche Anweisungen in robots.txt oder im HTTP-Header überlagert wird.
Wann sollte ich Noindex und wann Canonical verwenden?
Noindex eignet sich, wenn eine URL ausdrücklich nicht in den Index gelangen soll, etwa bei internen Suchergebnissen oder wenig hilfreichen Filter-URLs. Ein Canonical-Tag sollte genutzt werden, wenn mehrere sehr ähnliche Seiten existieren, deren Signale auf eine Hauptversion konsolidiert werden sollen, die weiterhin indexiert bleibt.
Kann eine per Noindex gesperrte Seite trotzdem gecrawlt werden?
Ja, eine per Noindex gekennzeichnete Seite wird in der Regel weiterhin gecrawlt, damit der Crawler die Anweisung überhaupt auslesen kann. Noindex verhindert die Aufnahme in den Index, nicht das Crawling selbst. Wenn du Crawling zusätzlich beschränken willst, kommen robots.txt oder technische Zugriffsbeschränkungen ins Spiel.
Wie lange dauert es, bis ein Noindex bei Google wirkt?
Die Wirkung eines Noindex hängt vom Crawl-Rhythmus der jeweiligen Seite ab. Erst wenn der Googlebot die Seite erneut besucht und das Noindex ausliest, wird sie nach und nach aus dem Index entfernt. Bei wichtigen Seiten oder stark verlinkten URLs kann dies schneller passieren als bei selten gecrawlten Seiten.
Sollten Paginierungsseiten im Online-Shop auf Noindex gesetzt werden?
In vielen Shops ist es sinnvoll, Paginierungsseiten mit Parametern wie page=2 oder page=3 auf Noindex,follow zu setzen, um den Fokus auf die Hauptkategorieseite zu legen und Duplicate-Content-Risiken zu reduzieren. Gleichzeitig bleiben die Produktlinks verfolgbar und die interne Verlinkung intakt.
Ist Noindex besser als Disallow in der robots.txt?
Für die gezielte Steuerung der Indexierung ist Noindex in der Regel besser geeignet als ein Disallow in der robots.txt, da Suchmaschinen beim Disallow zwar nicht crawlen, die URL aber trotzdem in den Index gelangen kann, etwa über externe Links. Noindex ist eine klare, auf der Seite selbst verankerte Anweisung gegen die Indexierung.
Wie erkenne ich, ob wichtige Seiten versehentlich auf Noindex stehen?
Du kannst mit SEO-Crawlern oder der Google Search Console prüfen, welche Seiten den Status ausgeschlossen durch Noindex-Meta-Tag haben. Zusätzlich ist ein regelmäßiger OnPage-SEO-Check sinnvoll, um Seitentyp-Templates zu kontrollieren und versehentliche globale Noindex-Ausrollungen frühzeitig zu erkennen.
10. Nächste Schritte: Noindex sauber steuern und Content skalieren
Ein durchdachtes Noindex-Konzept ist ein zentraler Baustein jeder technischen SEO-Strategie im E-Commerce. Gerade bei großen Produktkatalogen solltest du klare Regeln für jeden Seitentyp definieren, sie sauber im System abbilden und regelmäßig überprüfen, ob wichtige Landingpages indexiert und Hilfsseiten korrekt ausgeblendet werden.
Wenn du Produktcontent aus strukturierten Feeds automatisiert erzeugst, kannst du Noindex-Regeln direkt in deine Templates und Prozesse integrieren und so sicherstellen, dass neue und aktualisierte Seiten von Anfang an sauber für Nutzer und Suchmaschinen aufbereitet sind.
Du möchtest sehen, wie sich automatisierte Produkttexte und eine saubere technische SEO-Strategie in der Praxis verbinden lassen? Sieh dir die Funktionen von feed2content.ai® live an und teste sie mit deinen eigenen Produktdaten.
Kostenlos startenDu hast noch Fragen?

Keine Kommentare vorhanden