Reverse Proxy
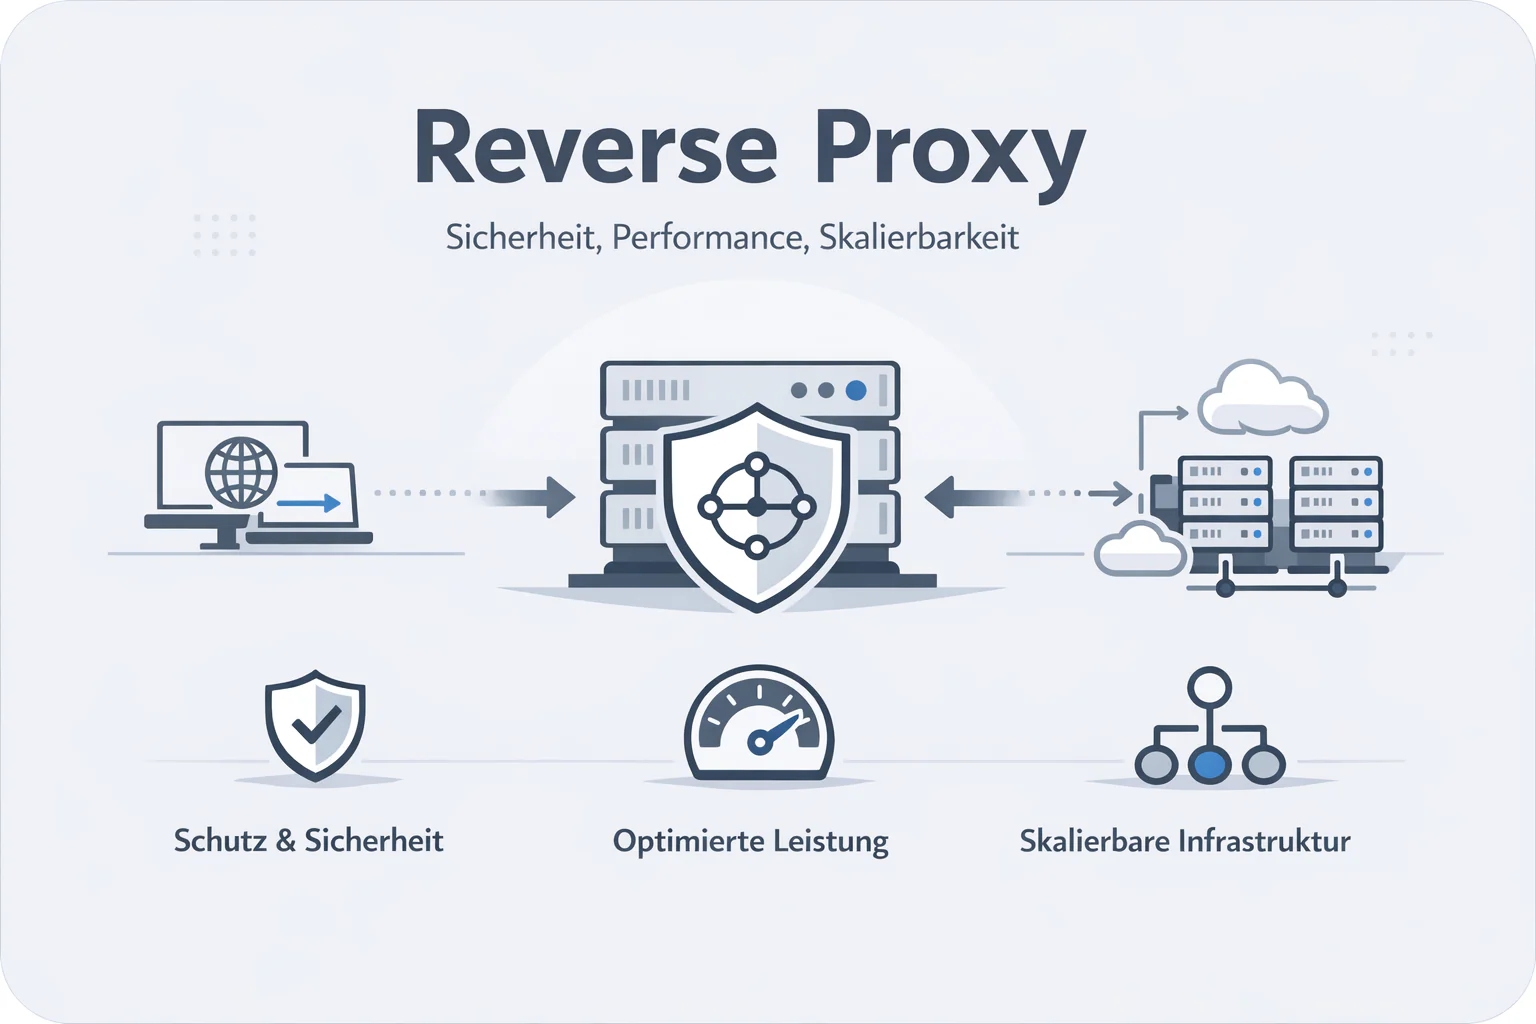
Was ist ein Reverse Proxy?
Ein Reverse Proxy ist ein Server, der zwischen Clients (z. B. Browsern) und einem oder mehreren Webservern sitzt und Anfragen stellvertretend entgegennimmt, weiterleitet und beantwortet. Er verbirgt die eigentlichen Zielserver, erhöht Sicherheit und Performance und ermöglicht flexible Skalierung von Webanwendungen.
1. Grundprinzip: Wie funktioniert ein Reverse Proxy?
Ein Reverse Proxy steht im Netzwerk vor einem oder mehreren Webservern und nimmt alle eingehenden HTTP- oder HTTPS-Anfragen entgegen. Für den Client wirkt der Reverse Proxy wie der eigentliche Webserver, tatsächlich leitet er die Anfrage jedoch intern an einen passenden Backend-Server weiter, holt die Antwort ab und sendet sie an den Client zurück.
Diese Vermittlerrolle ermöglicht es, Funktionen wie Lastverteilung, SSL-Terminierung, Caching und Zugriffsschutz zentral zu bündeln, statt sie auf jedem einzelnen Webserver separat zu konfigurieren.
2. Reverse Proxy vs. Forward Proxy: Abgrenzung der Begriffe
Ein häufiger Irrtum ist die Gleichsetzung von Reverse Proxy und klassischem Proxy-Server. Beide vermitteln Anfragen, erfüllen aber völlig unterschiedliche Aufgaben und stehen auf unterschiedlichen Seiten der Kommunikation.
| Kriterium | Reverse Proxy | Forward Proxy |
|---|---|---|
| Position im Netzwerk | Vor Webservern im Rechenzentrum | Vor Clients im internen Netz |
| Wen repräsentiert er? | Die Server | Die Clients |
| Hauptzweck | Schutz, Skalierung, Performance der Server | Zugriffskontrolle, Anonymisierung, Caching für Nutzer |
| Typisches Einsatzfeld | Webseiten, APIs, E-Commerce-Plattformen | Unternehmen, Schulen, öffentliche Netze |
Ein Reverse Proxy schützt also in erster Linie die Serverlandschaft eines Onlineshops oder einer Webanwendung, während ein Forward Proxy dazu dient, die Nutzer eines Netzwerks nach außen zu kapseln oder ihren Internetzugang zu steuern.
3. Zentrale Aufgaben eines Reverse Proxy im E-Commerce
Im E-Commerce mit vielen Besuchern, komplexen Shop-Systemen wie Shopware, Magento oder Shopify Plus und hohen Umsatzanforderungen erfüllt ein Reverse Proxy mehrere zentrale Aufgaben gleichzeitig.
Für Onlineshops mit stark schwankendem Traffic, beispielsweise zu Sales-Aktionen oder saisonalen Peaks, ist ein sauber konfigurierter Reverse Proxy ein entscheidender Baustein für Stabilität und Performance.
4. Technische Merkmale eines Reverse Proxy
Reverse Proxys lassen sich mit unterschiedlichen Softwarelösungen umsetzen, etwa Nginx, Apache HTTP Server mit mod_proxy, HAProxy oder auch spezialisierten Hardware-Appliances. Unabhängig von der konkreten Software weisen sie einige typische Merkmale auf.
Diese Funktionen machen den Reverse Proxy zur Schaltzentrale zwischen Internet und Infrastruktur, in der technische und sicherheitsrelevante Entscheidungen gebündelt werden.
5. Reverse Proxy und Performance: Caching, Kompression, Skalierung
Ein wesentlicher Vorteil eines Reverse Proxy ist die Verbesserung der Ladegeschwindigkeit, die sich direkt auf SEO, Conversion-Rate und Kosten pro Klick in Kampagnen auswirkt.
5.1 Technische Website-Checks rund um Reverse Proxy
Wenn du prüfen willst, wie dein Reverse Proxy, deine Ladezeiten und deine technische Suchmaschinenoptimierung zusammenspielen, kann ein OnPage-SEO-Check helfen, Engpässe in der Infrastruktur zu identifizieren.


6. Sicherheitsaspekte: Reverse Proxy als Schutzschicht
Ein Reverse Proxy erhöht die Sicherheit eines Onlineshops, weil er die interne Serverlandschaft abschirmt und als kontrollierbares Einfallstor fungiert. Angreifer sehen in der Regel nur die IP-Adresse des Reverse Proxy, nicht aber die der einzelnen Backend-Server.
7. Typische Einsatzszenarien für Reverse Proxy im Onlinehandel
Reverse Proxys kommen in nahezu jedem größeren E-Commerce-Setup zum Einsatz, oftmals ohne dass sich Fachabteilungen im Detail damit beschäftigen. Einige typische Szenarien:
Gerade bei automatisierter Content-Produktion und häufigen Content-Refreshes, wie sie mit Tools auf Basis von Produktfeeds üblich sind, ist eine stabile und skalierbare Proxy-Architektur wichtig, um wachsende Traffic-Spitzen zuverlässig abzufangen.
8. Übliche Softwarelösungen für Reverse Proxy
In der Praxis haben sich einige Softwarelösungen als Standard für Reverse-Proxys etabliert. Sie unterscheiden sich in Funktionsumfang, Performance und Komplexität.
Die Auswahl hängt von Anforderungen wie erwartete Last, vorhandene Expertise im Team, Integrationsanforderungen mit bestehenden Systemen und Budgetrahmen ab.
9. Reverse Proxy im Zusammenspiel mit SEO und Content
Für SEO, Conversion-Optimierung und Kampagnen-Performance spielt der Reverse Proxy indirekt eine wichtige Rolle. Er beeinflusst Ladezeiten, Verfügbarkeit und Stabilität von Landingpages und Produktdetailseiten.
Wer Produkttexte aus Feeds automatisiert erzeugt und regelmäßig aktualisiert, profitiert besonders von einer Infrastruktur, in der Reverse Proxy, Shop-System und Content-Prozesse sauber aufeinander abgestimmt sind.
10. Best Practices und typische Stolperfallen beim Einsatz von Reverse Proxy
Damit ein Reverse Proxy zuverlässig arbeitet und nicht selbst zur Fehlerquelle wird, sollten einige Best Practices beachtet werden.
11. Häufige Fragen zu Reverse Proxy
Was ist ein Reverse Proxy in einfachen Worten?
Ein Reverse Proxy ist ein vorgeschalteter Server, der Anfragen von Nutzern entgegennimmt, intern an einen geeigneten Webserver weiterleitet und die Antwort wieder an den Nutzer zurückschickt, sodass die eigentliche Serverlandschaft verborgen bleibt und zentral geschützt und beschleunigt werden kann.
Wann sollte ich einen Reverse Proxy einsetzen?
Ein Reverse Proxy ist sinnvoll, sobald mehrere Webserver im Einsatz sind, hohe Zugriffszahlen erwartet werden, sensible Daten verarbeitet werden oder zentrale Funktionen wie Lastverteilung, SSL-Terminierung, Caching und Sicherheitsfilter für eine Webanwendung oder einen Onlineshop benötigt werden.
Welche Vorteile bietet ein Reverse Proxy für Onlineshops?
Für Onlineshops bietet ein Reverse Proxy Vorteile wie schnellere Ladezeiten durch Caching und Kompression, höhere Verfügbarkeit durch Load Balancing, bessere Sicherheit durch Abschottung der Backend Server und zentrale Zugriffskontrolle sowie eine bessere Grundlage für stabile SEO und Kampagnenperformance.
Was ist der Unterschied zwischen Reverse Proxy und Load Balancer?
Ein Load Balancer verteilt in erster Linie Netzwerk oder HTTP Traffic auf mehrere Server, während ein Reverse Proxy zusätzlich weitere Funktionen übernimmt wie Caching, SSL Terminierung, Header Anpassungen oder Sicherheitsfilter, wobei viele moderne Lösungen beides in einem System kombinieren.
Ist ein Reverse Proxy das gleiche wie eine Firewall?
Ein Reverse Proxy ist keine klassische Firewall, kann aber bestimmte Sicherheitsfunktionen übernehmen, etwa als Web Application Firewall, indem er HTTP Anfragen filtert, begrenzt und analysiert, während eine Netzwerkfirewall hauptsächlich Ports und Verbindungen auf niedrigerer Ebene kontrolliert.
Welche Software eignet sich als Reverse Proxy?
Häufig genutzte Software für Reverse Proxys sind Nginx, HAProxy und Apache HTTP Server mit Proxy Modulen, außerdem bieten verschiedene Cloud und CDN Anbieter Reverse Proxy Funktionen als Dienst an, die je nach Leistungsanforderung, Know how im Team und bestehender Infrastruktur ausgewählt werden sollten.
Kann ein Reverse Proxy die SEO meiner Website beeinflussen?
Ein Reverse Proxy wirkt sich indirekt auf SEO aus, weil er Ladezeiten, Verfügbarkeit, Weiterleitungsregeln und das Handling von HTTPS beeinflusst, daher sollten Caching, Kompression, Redirects und Header so konfiguriert sein, dass Suchmaschinen die Website stabil, schnell und technisch sauber crawlen können.
12. Nächste Schritte: Du möchtest feed2content.ai kennenlernen?
Wenn deine Infrastruktur bereits mit Reverse Proxy, Caching und skalierbaren Shop-Systemen arbeitet, ist der nächste Hebel oft der Content selbst. Aus gut strukturierten Produktfeeds lassen sich automatisiert hochwertige, SEO-fähige Produkttexte erzeugen, die deine technische Basis optimal nutzen und dich schneller live bringen als manuelle Prozesse.
Kostenlos startenDu hast noch Fragen?

Keine Kommentare vorhanden